arXiv · OCTOBER 2026
Qwen learns to improve Qwen—and outperforms GPT-6-sol.
Language Models Learn to Improve Language Models · LM2LM
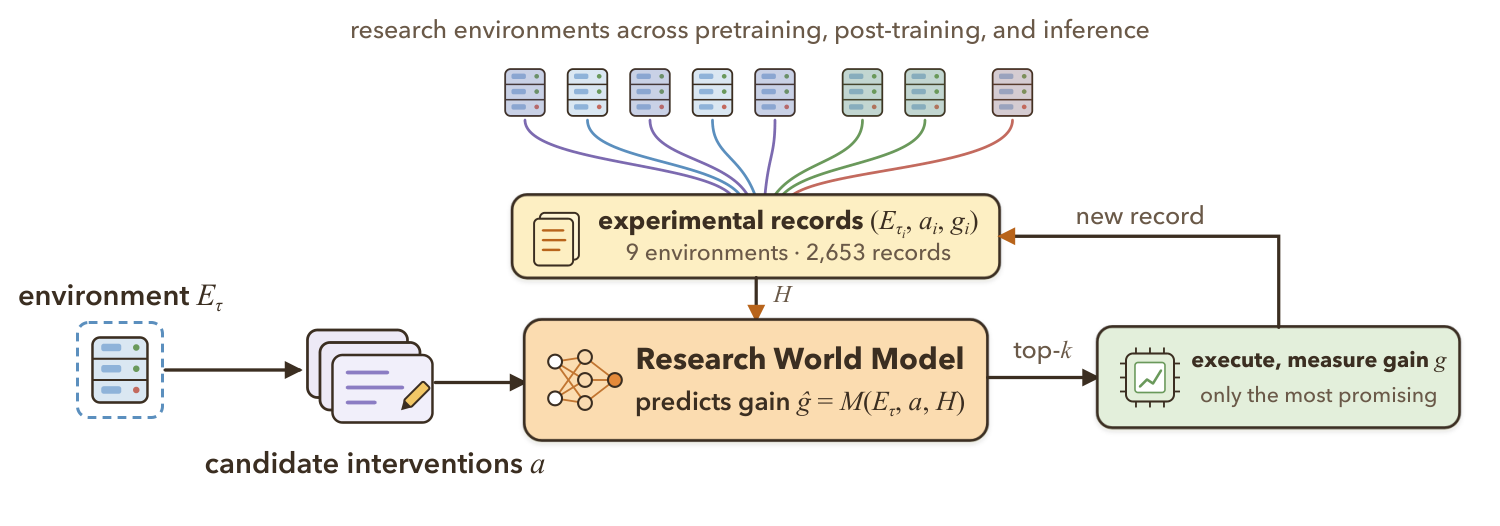
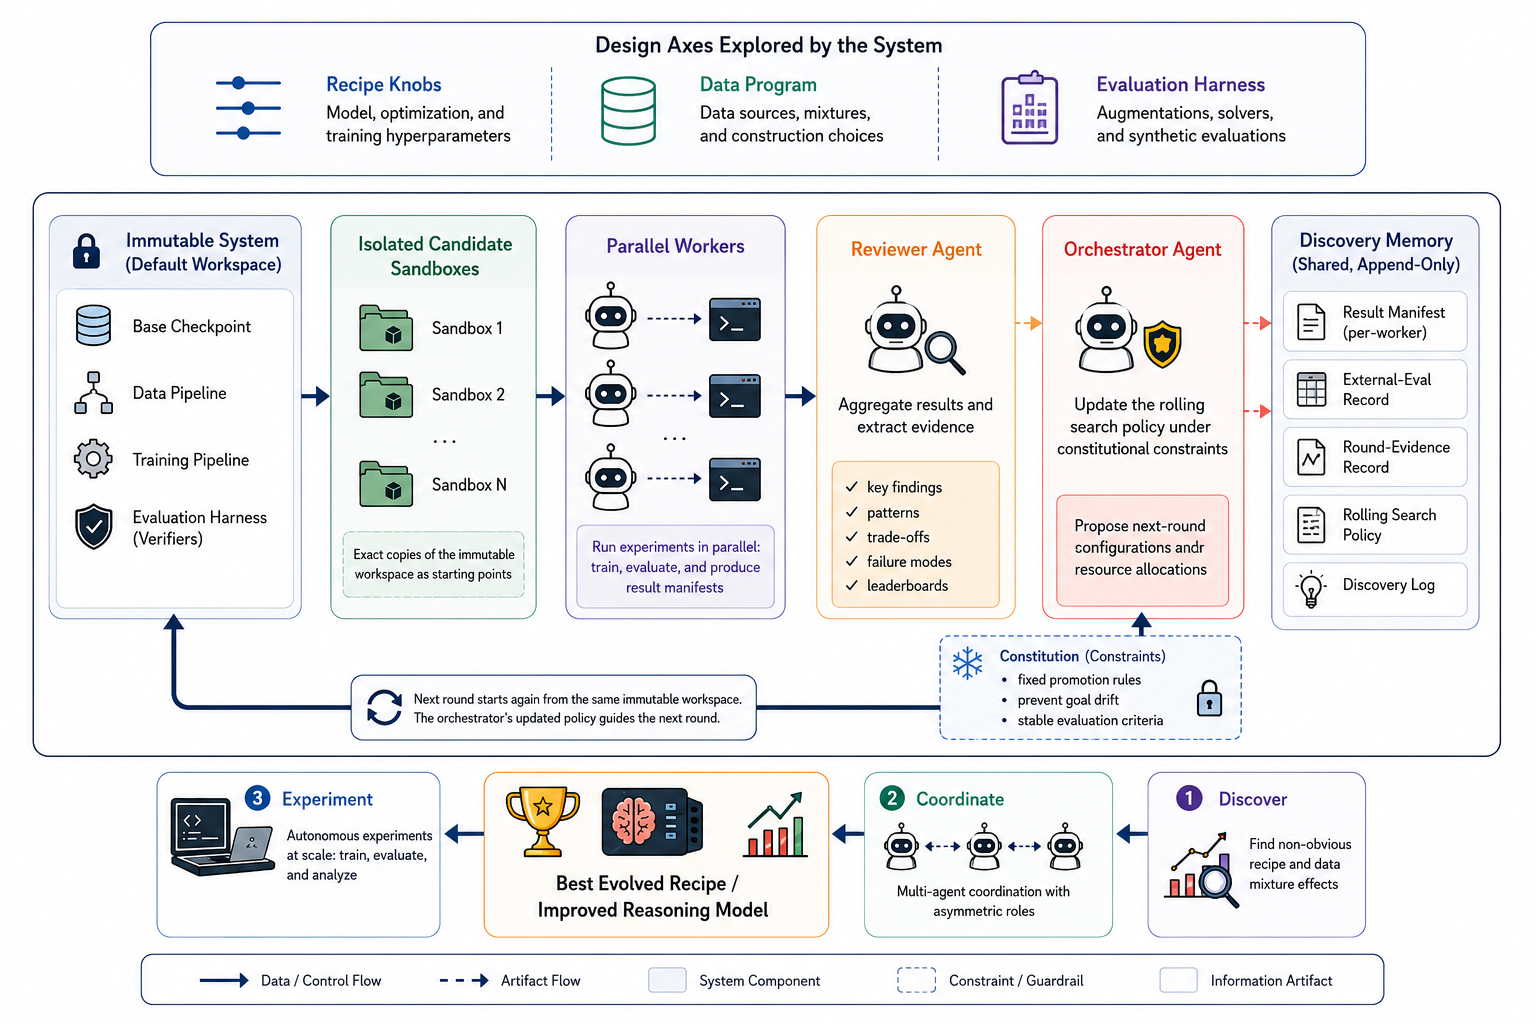
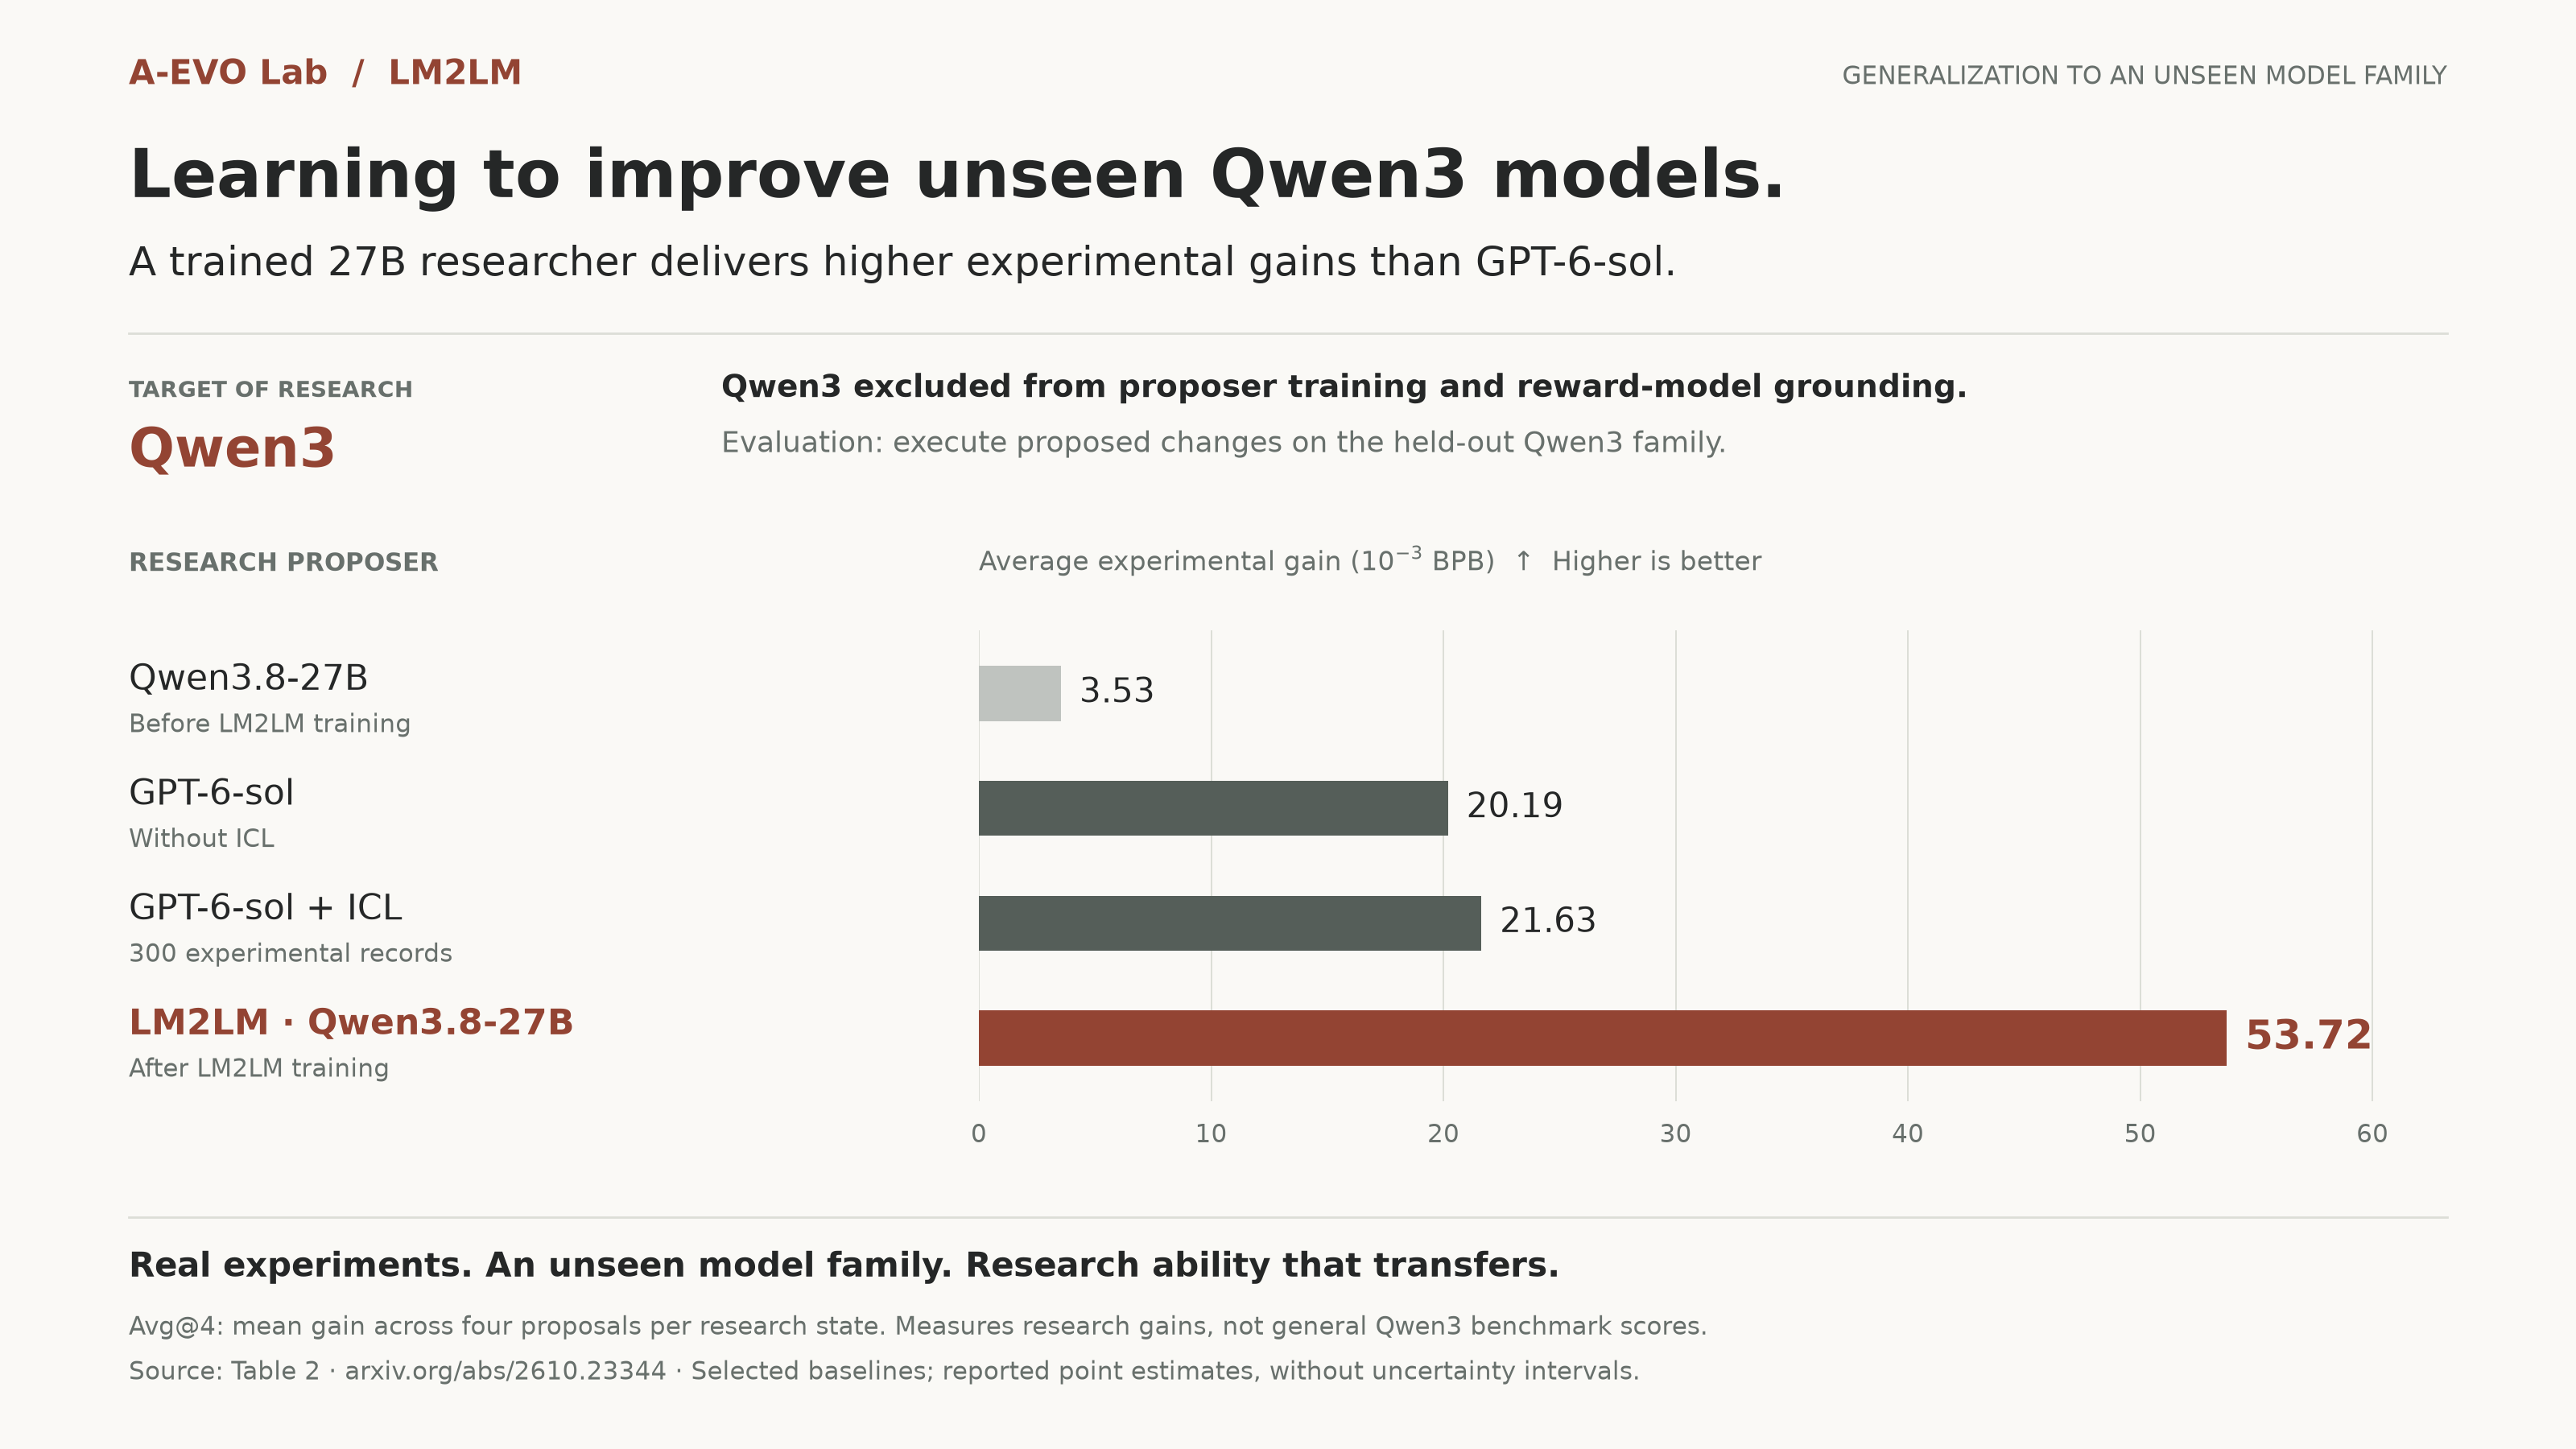
A 27B research model trained with RL achieves higher average experimental gains on a held-out Qwen3 family than GPT-6-sol—even with 300 experimental records in context. Research World Model rewards make training scalable, while real experiments keep the feedback grounded.
Held-out Qwen3 · Avg@4 gain: 53.72 vs. 21.63 for GPT-6-sol + ICL (10⁻³ BPB)